템플릿은 초기에 type-safe 컨테이너를 위해 만들어졌다.
하지만 많은 사람들이 템플릿을 사용하게 되며, 템플릿 기능의 폭이 넓어졌다.
for_each, find, merge같은 알고리즘이 예시이다.
템플릿 메타프로그래밍이 발전하며, 컴파일 시점에 코드를 생성하고 런타임 부하를 줄이는 기술이 늘었다.
템플릿 메타프로그래밍 - 위키백과, 우리 모두의 백과사전
위키백과, 우리 모두의 백과사전. 템플릿 메타프로그래밍(template metaprogramming)은 템플릿을 사용하는 프로그래밍 기법으로, 컴파일러에게 프로그램 코드를 생성하도록 하는 방식이다. 이러한 기
ko.wikipedia.org
Item41: 암시적 인터페이스와 컴파일 타임 다형성을 이해하라.
객체 지향 프로그래밍의 세계는 명시적 인터페이스와 런타임 다형성을 중심으로 돌아간다.
class Widget {
public:
    Widget();
    virtual ~Widget();
    virtual std::size_t size() const;
    virtual void normalize();
    void swap(Widget& other);
    …
};
void doProcessing(Widget& w) {
if (w.size() > 10 && w != someNastyWidget) {
Widget temp(w);
temp.normalize();
temp.swap(w);
}
}일 때 doProcessing을 위해서 Widget 인터페이스를 지원해야 한다.
이를 코드에서 확인할 수 있기 때문에 명시적 인터페이스라고 한다.
Widget 멤버 함수의 일부가 virtual이기 때문에 w를 통한 함수 호출은 런타임 다형성이다.
다만 템플릿, 제네렉 프로그래밍의 세계는 다르다.
명시적 인터페이스, 런타임 다형성도 있지만,
암시적 인터페이스, 컴파일 타임 다형성이 더 중요하게 다뤄진다.
template<typename T>
void doProcessing(T& w) {
    if (w.size() > 10 && w != someNastyWidget) {
        T temp(w);
        temp.normalize();
        temp.swap(w);
    }
}
코드를 보면
T라는 타입은 size, normalize, swap 함수를 지원해야 하고, someNastyWidget과 비교 연산이 가능해야 하는 등의 제약조건이 필요하다.
암시적 인터페이스는 이러한 유효한 표현식(valid expressions)으로 구성된다.
이러한 다형성은 컴파일 시점에, 템플릿 인스턴스화와 오버로딩 해석을 통해 발생한다.
Item42: typename의 두 가지 의미를 이해하라.
기본적으로 템플릿 선언에서 class와 typename은 차이가 없다.
template<class T> class Widget;    // "class" 사용
template<typename T> class Widget; // "typename" 사용
하지만 어떤 경우에는 반드시 typename을 사용해야 한다.
template<typename C>
void print2nd(const C& container) {
    if (container.size() >= 2) {
        C::const_iterator iter(container.begin());
        ...
    }
}
이와 같은 경우 C에 있는 const_iterator가 타입 이름인지, 멤버 변수인지 등등 컴파일러가 명확하게 알 수 없다.
따라서 이 경우에는 (템플릿을 사용하는 스코프에서의 중첩 의존 타입 이름 사용)
template<typename C>
void print2nd(const C& container) {
    if (container.size() >= 2) {
        typename C::const_iterator iter(container.begin());
        ...
    }
}
이렇게 typename을 붙이는 것이 좋다.
Item43: 템플릿 기반의 기본 클래스에서 이름을 어떻게 참조하는지 알아두라.
class CompanyA {
public:
    ...
    void sendCleartext(const std::string& msg);
    void sendEncrypted(const std::string& msg);
    ...
};

class CompanyB {
public:
    ...
    void sendCleartext(const std::string& msg);
    void sendEncrypted(const std::string& msg);
    ...
};

class MsgInfo { ... }; // 메시지 생성에 필요한 정보 저장용 클래스

template<typename Company>
class MsgSender {
public:
    ...
    void sendClear(const MsgInfo& info) {
        std::string msg;
        // info로부터 메시지 생성
        Company c;
        c.sendCleartext(msg);
    }

    void sendSecret(const MsgInfo& info) {
        // 암호화된 메시지 전송용 (c.sendEncrypted 호출)
    }
};
template<typename Company>
class LoggingMsgSender : public MsgSender<Company> {
public:
...
void sendClearMsg(const MsgInfo& info) {
// 로그: 보내기 전에 정보 기록
sendClear(info); // 기반 클래스의 함수 호출
// 하지만 컴파일 안 됨
// 로그: 보낸 후 정보 기록
}
};이 경우에 sendClaer는 호출되지 못한다.
이유는 템플릿 기반 상속일 때 컴파일러는 기반 클래스의 이름을 자동으로 찾지 않기 때문이다.
MsgSender<Company>를 상속받는 것이지만, 이 Company라는 템플릿 typename은 LoggingMsgSender가 인스턴스화 될 때 까지는 무엇인지 알 수 없고, 따라서 MsgSender<Company>에 sendClear가 있는지 판단할 수 없는 것이다.
특히 템플릿 특수화를 생각하면 쉽다. 특수화된 템플릿에는 특정 멤버 함수가 존재하지 않을 수 있다.
따라서 호출 안됨
그래서 어떻게 함?
- this->sendClear()
- using Base<T>::sendClear
- Base<T>::sendClear() (단, 가상 함수가 아니어야 안전)
위와 같은 3가지 방법을 통해서 템플릿 기반의 파생 클래스에서, 기반 클래스의 이름을 참조할 수 있다.
결론
this->를 붙이거나, using 선언을 하거나, 클래스 이름을 명시적으로 붙이자.
Item44: 템플릿에서 매개변수와 무관한 코드를 분리하라.
템플릿을 작성할 때는 공통성과 가변성 분석(commonality and variability analysis)을 통해 매개변수에 의존하지 않는 공통 코드를 따로 분리 해야 한다.
그게 뭔데?
만약 두 개의 함수 구현이 80퍼가 같고 20퍼가 다르면 중복 코드를 분리해 공통 함수로 만들고 나머지를 인자를 다르게 하거나, 분기 처리할 것이다.
클래스도 마찬가지라고 생각하면 된다.
템플릿에서는 중복이 눈에 보이지 않기 때문에 주의 해야 한다.
하나의 템플릿 정의가 수십 번 복사되어 빌드 바이너리를 부풀릴 수 있다.
template<typename T, std::size_t n> // 타입 T, 크기 n
class SquareMatrix {
public:
    void invert(); // 행렬 반전
};
SquareMatrix<double, 5> sm1;
sm1.invert(); // → SquareMatrix<double, 5>::invert()
SquareMatrix<double, 10> sm2;
sm2.invert(); // → SquareMatrix<double, 10>::invert()이 경우에 invert() 함수는 두 번 인스턴스화 된다.
둘의 내부 구현이 거의 동일해도, 크기가 다르기 때문이다.
(중복 코드 생성)
따라서 템플릿 내부에서 인자와 무관한 부분은 공통화 해야 한다.
(템플릿 매개변수에 의존하지 않는 코드는 분리)
// 크기(size)와 무관한 공통 베이스 클래스
template<typename T>
class SquareMatrixBase {
protected:
    void invert(std::size_t matrixSize);  // 주어진 크기의 행렬을 반전
};

// 크기를 받는 템플릿 SquareMatrix 클래스
template<typename T, std::size_t n>
class SquareMatrix : private SquareMatrixBase<T> {
    using SquareMatrixBase<T>::invert; // 기반 클래스 함수 가시성 확보

public:
    ...
    void invert() { invert(n); } // 크기를 인자로 넘겨 기반 함수 호출
};
이런 식으로 size_t를 인자로 받으면 중복을 줄일 수 있을 것이다.
비타입 템플릿 매개변수(값 인자)는 특히 부풀림의 원인이 되기 때문에 주의하자. (타입 인자에 비해 훨씬)
Item45: 호환 가능한 모든 타입을 받기 위해 멤버 함수 템플릿을 사용하라.
스마트 포인터는 자원을 적절한 시점에 자동으로 삭제해주는 등 포인터에 비해 유용한 기능들이 있지만,
일반 포인터가 잘하는 암시적 형변환의 경우 적용이 까다롭다.
class Top { ... };
class Middle : public Top { ... };
class Bottom : public Middle { ... };

Top *pt1 = new Middle;     // Middle* → Top*
Top *pt2 = new Bottom;     // Bottom* → Top*
const Top *pct2 = pt1;     // Top* → const Top*
예를 들어 이렇게 일반 포인터는 암시적 캐스팅이 가능하지만,
SmartPtr<Top> pt1 = SmartPtr<Middle>(new Middle);     // SmartPtr<Middle> → SmartPtr<Top>
SmartPtr<Top> pt2 = SmartPtr<Bottom>(new Bottom);     // SmartPtr<Bottom> → SmartPtr<Top>
SmartPtr<const Top> pct2 = pt1;                       // SmartPtr<Top> → SmartPtr<const Top>
스마트 포인터의 경우 위와 같이 시도하는 경우 캐스팅이 불가하다.
SmartPtr<Middle>과 SmartPtr<Top>은 관련 없는 타입이다.
따라서 캐스팅을 하기 위해 복사 생성자에 명시적으로 멤버 함수 템플릿을 추가하는 등의 행위가 필요하다.
template<typename T>
class SmartPtr {
public:
    template<typename U>
    SmartPtr(const SmartPtr<U>& other)
    : heldPtr(other.get())  // SmartPtr<U>가 가진 포인터로 초기화
    { }

    T* get() const { return heldPtr; }

private:
    T* heldPtr;  // 내부에 실제 포인터를 들고 있음
};
위의 코드를 잘보고 이해하자.
생성자로 SmartPtr<U> 타입의 인자를 받는다.
이 때 초기화 리스트를 통해 멤버 변수인 heldPtr을 other.get()을 통해 초기화한다.
heldPtr은 T*타입이고, other.get()은 U*타입이기 때문에, U*->T*으로 암시적 변환이 가능한 경우에만 컴파일 된다.
복사 생성자, 복사 대입 연산에도 멤버 함수 템플릿이 유용하게 사용될 수 있다.
다만 템플릿 타입 T와 Y가 같은 타입인 경우 자동으로 일반 복사 생성자나 대입 연산자를 생성할 수 있기 때문에 필요하다면 명시적으로 선언이 필요하다.
결론
멤버 함수 템플릿 사용 시에는 호환 가능한 모든 타입을 받는 함수를 생성할 수 있다.
하지만 일반화된 복사 생성자 또는 일반화된 대입 연산자를 멤버 템플릿으로 선언하더라도, 일반 복사 생성자와 일반 복사 대입 연산자는 그대로 직접 선언해야 한다.
Item46: 암시적 형변환이 필요한 경우, 템플릿 내부에 비멤버 함수를 정의하라.
template<typename T>
class Rational {
public:
    Rational(const T& numerator = 0,
             const T& denominator = 1);  // [Item 20] 참고 — 참조로 전달

    const T numerator() const;          // [Item 28] 참고 — 반환은 값으로
    const T denominator() const;       // [Item 3] 참고 — 왜 const인지
    ...
};

template<typename T>
Rational<T> operator*(const Rational<T>& lhs,
                      const Rational<T>& rhs) {
    ...
}
이러한 경우
Rational<int> oneHalf(1, 2);           // [Item 24] 예제 그대로
Rational<int> result = oneHalf * 2;    // 컴파일 오류 발생!
이전에 봤던 예시와 다르게(item 24) 컴파일러가 어떤 함수를 인스턴스화해야 할지 모른다.
생성자에 의한 암시적 형 변환은 템플릿 인자 추론 시점에서는 고려되지 않기 때문에
Rational<int>의 생성자를 통해서 int를 Rational<int>로 바꿀 수 없다.
템플릿 인자 추론은 함수 호출 전에 이루어지며, 그때는 어떤 함수가 존재하는지 정확히 알고 있어야 한다.
해결 방법
friend 함수를 통해서 해결한다.
템플릿 클래스 내의 friend 선언을 사용하면, 클래스가 인스턴스화되면서, 타입에 맞는 friend 함수 operator*도 자동으로 선언된다.
함수 템플릿이 아닌 함수이기 때문에 컴파일러가 암시적 변환 함수들을 사용할 수 있게 된다.
다만 이 함수를 클래스 내에서 선언만 하면, 링크 되지 못하기 때문에, 정의까지 해야 한다.
template<typename T>
class Rational {
public:
    friend const Rational operator*(const Rational& lhs, const Rational& rhs)
    {
        return Rational(lhs.numerator() * rhs.numerator(),
                        lhs.denominator() * rhs.denominator());
    }
};
결론적으로 위와 같이, friend 선언과 함수의 정의가 모두 필요하게 되었다.
Item30에서 언급했듯이, 클래스 안에서 정의된 함수는 자동으로 inline 함수가 되기 때문에, 구현을 클래스 밖의 헬퍼 함수로 옮기는 것이 좋다.
template<typename T> class Rational;

template<typename T>
const Rational<T> doMultiply(const Rational<T>& lhs, const Rational<T>& rhs); // helper 템플릿
결론: 클래스 템플릿을 작성할 때, 관련된 연산자 함수에서 모든 인자에 대해 암시적 형 변환을 허용하고 싶다면, 그 함수들을 friend로 선언된 비멤버 함수로 구현하라.
Item47: 타입에 대한 정보를 얻기 위해 traits 클래스를 사용하라.
STL은 컨테이너, iterator, 알고리즘을 위한 템플릿이지만,
추가적으로 유용한 유틸리티 템플릿들도 있다.
그 중 하나가 advance 템플릿이다.
template<typename IterT, typename DistT>
void advance(IterT& iter, DistT d);
// d만큼 이동
// d > 0이면 전진, d < 0이면 후진
advance는 주어진 반복자를 특정 거리만큼 이동시킨다.
그냥 보면 iter += d(거리) 만큼 이동하는 것 같지만,
실제로는 다른 점이 있다.
이렇게 간단하게 이동할 수 있는 것은 random access iterator만 가능하고,
다른 약한(less powerful) 반복자 타입들은 ++, -- 를 반복적으로 사용해서 한 칸씩 이동하는 방식을 사용한다.
STL 반복자 타입
Input Iterators
- 한 번에 한 칸씩만 앞으로 이동 가능
- 읽기 전용
- istream_iterator 같은 게 여기에 해당
Output Iterators
- input iterator의 반대
- 한 번에 한 칸씩만 앞으로 이동 가능
- 쓰기 전용
- 예: ostream_iterator
input/output 반복자는 기능이 매우 제한되어 있다.
이들은 오직 한 방향으로만 움직이며, 한번 접근한 요소는 다시 접근할 수 없다.
그렇기에 이 반복자들은 다중 패스 알고리즘에 부적합하다.
Forward Iterators
- input/output 둘 다 가능한 버전
- 같은 요소를 여러 번 읽거나 쓸 수 있음
- 리스트나 해시 컨테이너에서 주로 사용됨
- std::list, std::forward_list, unordered_map 등에서 사용
Bidirectional Iterators
- forward iterator가 뒤로도 움직일 수 있게 된 것
- 예: std::set, std::map, std::list
Random Access Iterators
- 가장 강력한 반복자
- +, -, <, >= 등의 연산 가능
- 벡터처럼 인덱싱이 가능한 컨테이너에 쓰임
- 예: std::vector, std::deque, std::string
이 반복자들은 산술 연산이 가능하다.
배열처럼 iter + 5 또는 iter[3] 같은 연산도 된다.
마치 포인터처럼 동작한다.
이러한 반복자 카테고리는 각각의 컨테이너나 알고리즘의 성능 및 기능에 큰 영향을 끼친다.
random access iterator의 경우 advance에서 +=을 사용할 수 있고, 이는 성능적으로 매우 유용하기 때문에 가능하다면 사용해야 한다.
따라서 iterator가 어떤 iterator인지 판별이 필요하다.
이를 위해 traits을 사용한다.
traits는 컴파일 타임에 타입에 대한 정보를 알아내기 위한 도구이다.
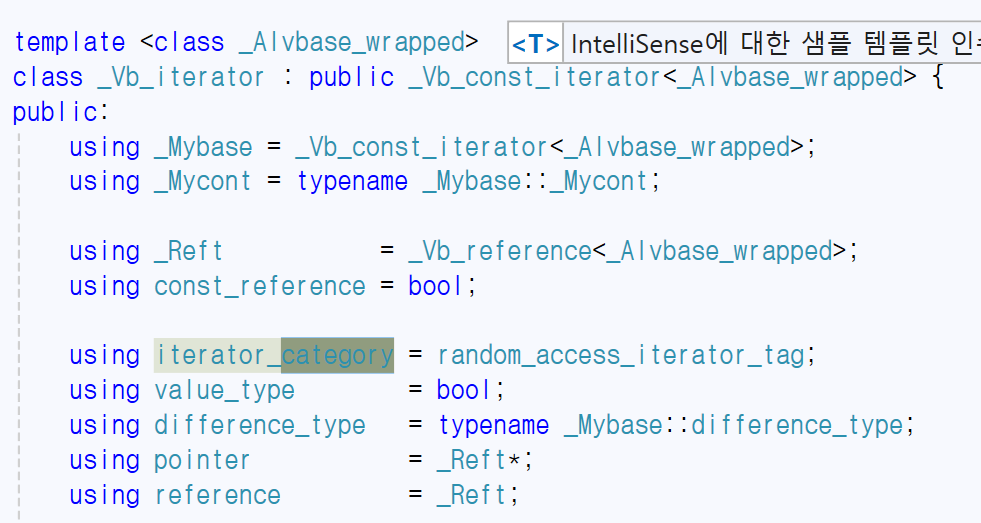
iterator_traits<반복자 타입> 구조체 안에는 iterator_category라는 typedef가 정의되어 있어야 한다.
이를 통해서 해당 반복자가 어떤 태그인지 식별한다.
1차 코드 작성
template<typename IterT, typename DistT>
void advance(IterT& iter, DistT d)
{
  if (typeid(typename std::iterator_traits<IterT>::iterator_category)
      == typeid(std::random_access_iterator_tag))
  {
    iter += d;
  }
  ...
}
IterT는 컴파일 타임에 알 수 있지만, 위의 코드는 런타임에 작동하는 코드이기 때문에 if문을 활용할 필요가 없다.
-> 오버로딩을 사용한다. (컴파일 타임 분기)
// random access 반복자용
template<typename IterT, typename DistT>
void doAdvance(IterT& iter, DistT d,
               std::random_access_iterator_tag)
{
  iter += d;
}

// bidirectional 반복자용
template<typename IterT, typename DistT>
void doAdvance(IterT& iter, DistT d,
               std::bidirectional_iterator_tag)
{
  if (d >= 0) while (d--) ++iter;
  else        while (d++) --iter;
}

// input 반복자용
template<typename IterT, typename DistT>
void doAdvance(IterT& iter, DistT d,
               std::input_iterator_tag)
{
  if (d < 0)
    throw std::out_of_range("Negative distance"); // 입력 반복자는 후진 불가
  while (d--) ++iter;
}
template<typename IterT, typename DistT>
void advance(IterT& iter, DistT d)
{
doAdvance(
iter, d,
typename std::iterator_traits<IterT>::iterator_category()
);
}따라서 위와 같이 구현한다면, 컴파일 타임 분기가 가능하다.
결론
1. Traits 클래스는 템플릿, 템플릿 특수화를 통해 컴파일 시간에 타입 관련 정보를 알아낼 수 있도록 해준다.
2. 오버로딩과 함께 사용하면, traits 덕분에 컴파일 타입 if-else 분기도 가능하다.
Item48: 타입에 대한 정보를 얻기 위해 traits 클래스를 사용하라.
Template Meta Programming(TMP)은 컴파일 중 실행되는 C++ 프로그램을 작성하는 기법이다.
TMP 프로그램이 실행되면, 그 결과는 C++ 코드의 일부가 된다.
TMP의 장점
TMP는 일반적으로 어렵거나 불가능한 일을 쉽게 만들어 준다.
TMP는 컴파일 타임에 프로그램을 실행하기 때문에, 런타임 오버헤드를 줄일 수 있다.
TMP의 단점
TMP로 작성한 코드가 이해하기 어렵고, 컴파일 시간이 오래 걸릴 수 있다.
예시
template<typename IterT, typename DistT>
void advance(IterT& iter, DistT d)
{
  if (typeid(typename std::iterator_traits<IterT>::iterator_category) ==
      typeid(std::random_access_iterator_tag))
  {
    iter += d;                         // 반복자 산술 연산
  }
  else {
    if (d >= 0) while (d--) ++iter;    // 반복적 전진
    else       while (d++) --iter;     // 반복적 후진
  }
}
typeid는 런타입 타입 정보(RTTI) 기능이다.
if 문은 런타임 분기이기 때문에 조건이 false 더라도, 컴파일 타임에 두 경로 모두 파싱해서 타입체크를 한다.
-> 만약 random iterator가 아니라면 += 자체가 불가하기 때문에 컴파일 에러가 발생한다.
따라서 Item47처럼 구현한다.
TMP에서의 조건
Item47처럼 오버로딩을 통해 해결한다.
TMP에서의 루프
template <unsigned n>
struct Factorial {
    enum { value = n * Factorial<n - 1>::value };
};

template<>
struct Factorial<0> {
    enum { value = 1 };
};
재귀를 통해서 동일한 효과를 얻을 수 있다.
결론
TMP는 런타임 작업을 컴파일 타임으로 옮길 수 있게 해준다.
TMP는 타입에 따라 정책을 자동으로 선택해 최적화된 코드를 생성하거나, 잘못된 조합은 자동으로 배제하도록 만들 수 있다.
'C, C++ > Effective C++' 카테고리의 다른 글
| [Effective C++] 2장 C++의 규칙 따르자 (0) | 2026.02.06 |
|---|---|
| [Effective C++] 1장 C++의 규칙 따르자 (0) | 2026.02.04 |
| 6장 상속과 객체 지향 디자인 (0) | 2025.03.28 |
| 5장 구현 (0) | 2025.03.25 |
| 4장 설계와 선언 (0) | 2025.03.21 |